Com fer cercable un PDF escanejat amb OCR
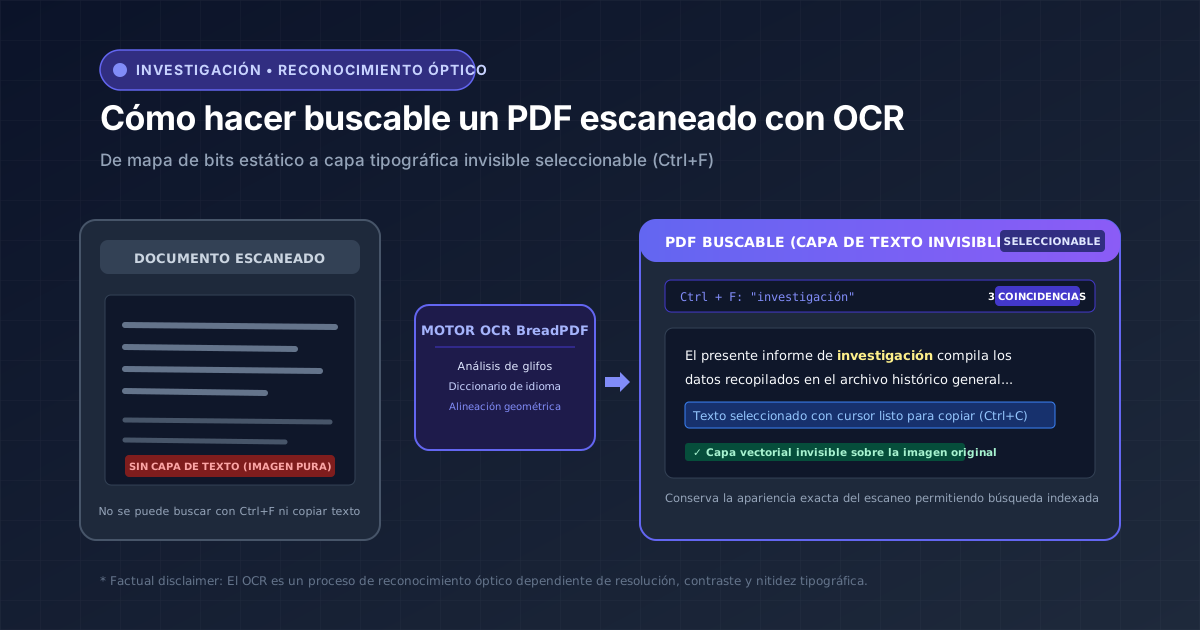
Si un PDF escanejat conté les pàgines com a imatges, és molt probable que no puguis seleccionar ni cercar el seu text amb Ctrl+F. La tecnologia OCR analitza les formes dels caràcters per incrustar una capa invisible que permet localitzar termes clau, copiar cites i indexar documents.
Cap motor d'OCR reconeix qualsevol document amb un 100% de precisió ni reconstrueix màgicament pàgines deteriorades. La nitidesa depèn de la resolució, contrast fons-lletra, inclinació i cal·ligrafia. La verificació ocular de xifres i noms és indispensable.
Reconeixement òptic precís executat directament al teu navegador
El motor de visió artificial processa cada caràcter en local mitjançant WebAssembly. El teu document no puja a cap servidor extern i manté la teva informació confidencial.
Com saber si el teu PDF necessita OCR?
Un document pot llegir-se amb absoluta claredat a la pantalla i, tanmateix, ser completament 'cec' per als motors de cerca o gestors bibliogràfics. Fes aquestes 3 proves ràpides:
Escriu una paraula que vegis clarament a la pàgina. Si el cercador indica '0 resultats', el document no té capa de text digital.
Fes clic i arrossega sobre una línia. Si no pots ressaltar caràcters individuals i s'arrossega una capsa blava sobre tota la imatge, és un mapa de bits.
Prem Ctrl+C i enganxa-ho en un bloc de notes. Si no s'enganxa cap text o surten símbols incomprensibles, requereix OCR.
Què fa realment l'OCR?
El reconeixement òptic no substitueix màgicament el teu document per un arxiu nou ni redibuixa les lletres. Funciona en una seqüència estructurada de visió artificial i anàlisi de glifs:
Imatge escanejada
Matriu de píxels en escala de grisos o color.
Anàlisi de glifs
Detecció de formes, línies i separació de paraules.
Capa invisible
Generació de caràcters transparents sobre coordenades exactes.
Document cercable
Ctrl+F actiu, selecció tipogràfica i còpia.
Com fer el teu PDF cercable pas a pas
Pas 1: Prepara i orienta el document
Els motors d'OCR analitzen el text en horitzontal d'esquerra a dreta. Si una pàgina està girada 90° o 180°, l'algoritme no podrà reconèixer els caràcters. A més, eliminar pàgines en blanc redueix el temps de procés:
Hacer OCR al PDF a BreadPDF
Selecciona l'idioma principal del text per activar el diccionari morfològic i descarrega un PDF cercable amb text indexable.
Pas 3: Comprova que l'OCR funciona
Limitacions conegudes: Taules i escriptura manuscrita
Taules i dades numèriques
L'OCR reconeix caràcters, però no reconstrueix la relació entre files i columnes. Si necessites editar xifres en un full de càlcul, aplica OCR primer i passa el document per PDF a Excel.
Escriptura a mà (Manuscrita)
Els sistemes estàndard d'OCR estan calibrats per a caràcters d'impremta o fonts digitals. La cal·ligrafia lliure o firmes manuscrites presenten taxes d'error significatives.
Casos pràctics i fluxos recomanats
| Tipus de document | Flux recomanat | Objectiu principal |
|---|---|---|
| Llibre o article d'arxiu escanejat | Rotar PDF → OCR de PDF | Cerca amb Ctrl+F i citació bibliogràfica indexable. |
| Apunts de classe impresos | OCR de PDF → Extraer texto (.txt) | Copiar resums a Word o processadors d'apunts. |
| Factura o balanç en paper escanejat | OCR de PDF → PDF a Excel | Estructurar columnes i auditar xifres amb sumes. |
| Expedient jurídic o administratiu | OCR de PDF + Comprovació ocular | Localitzar antecedents i números de procediment. |